
商品写真からサプライチェーンの意思決定へ
小売業者のカタログに、新しいワンピースが追加されます。あるのは写真と短い説明だけで、販売履歴はありません。最初の発注をする前に、バイヤーは過去に販売した商品との有用な比較を必要とします。「婦人用ワンピース」としか書かれていない説明よりも、シルエットや柄のほうが重要かもしれません。
Lokadは、サプライチェーンの計算に商品写真を利用できるようになりました。この機能は、予測とサプライチェーンの意思決定のためのLokadのプログラミング言語、Envisionに組み込まれています。各画像を*埋め込み(embedding)*に変換します。これは、視覚情報を計算で利用できるようにする、コンパクトな数値表現です。

埋め込みの役割
写真には数百万もの画素値が含まれています。画像で学習したモデルは、それらをはるかに短い数値のリスト、つまり埋め込みに変換します。これらの数値は、形状や質感、画像内の要素の配置などの視覚的なパターンを表します。「青」や「長袖」といったラベルの一覧ではありません。
二つの埋め込みを比較すると、見た目の類似度を測れます。花柄の夏用ワンピース同士は、ワンピースと冬用コートよりも似ていると判定されることが多いでしょう。一方に詳しい説明があり、もう一方に仕入先の商品コードしかない場合でも同様です。ソフトウェアは、誰かが目に見える特徴を一つずつラベル付けしなくても、カタログ全体からこうした関係を見つけられます。
Lokadはすでに、説明文の比較にテキストの埋め込みを利用しています。画像の埋め込みは、名称や仕様の文章だけでは十分に伝わらない商品について、補完的な見方を提供します。
販売済みの商品から学ぶ
新商品の発売に際しては、見た目の類似性が、どの既存商品の販売履歴に重みを与えるかを選ぶ助けになります。ただし、それぞれの販売シーズン、販売チャネル、在庫の有無も依然として重要です。似たワンピースの販売数が少ないのは、入荷が遅れたため、あるいは頻繁に欠品していたためかもしれません。その記録を新商品の予測に使う前に、背景を読み解く必要があります。
季節性も用途の一つです。新商品には季節ごとの販売履歴がありませんが、視覚的な特徴が近い既存商品から、いつ売れるかの手がかりを得られる場合があります。季節的なパターンは日付のある販売データから得られ、画像はどの履歴が関連するかをモデルが判断する助けになります。
説明文の乏しいカタログの分類にも、画像を活用できます。小売業者独自のカテゴリで学習した分類器は、視覚情報を使ってカテゴリを提案したり、分類先が不適切に見える商品を指摘したりできます。これにより、カタログの情報充実を、人が商品を一つずつラベル付けする作業だけに頼らずに済みます。
代替やカニバリゼーションについては、見た目の類似性から代替候補を特定できます。顧客が候補間で購入先を切り替えるのか、新しいスタイルが既存商品の需要を奪うのかを推定するには、販売と在庫の記録が必要です。二つのワンピースは似ていても、価格が異なり、異なる顧客層に向けられているかもしれません。画像は、こうした違いを考慮すべきモデルに判断材料を提供します。
計算の中で再利用できる要素
商品写真の横に似た商品の一覧を表示するデモは、よく見られます。これは商品を探すのに便利です。サプライチェーンの計算では、別の用途にも利用できるよう、その基盤となる表現にアクセスする必要があります。
Envisionでは、数値と同じように、埋め込みを保存して計算に利用できます。LokadのSupply Chain Scientistsは、この言語を使って各顧客の予測と意思決定のロジックを開発しています。ある商品の画像の埋め込みを別の商品と比較したり、視覚とテキストの信号を、価格、取引、在庫状況とともにモデルに組み込んだりできます。
これらの計算は、Envisionの観測データからモデルのパラメータを学習する仕組みであるautodiffに組み込めます。サイエンティストは、顧客の事業で視覚情報が売上とどう関係するかを学習するモデルを当てはめることができます。画像モデルが視覚表現を提供し、顧客の記録が、その使い方をサプライチェーンモデルに学習させます。
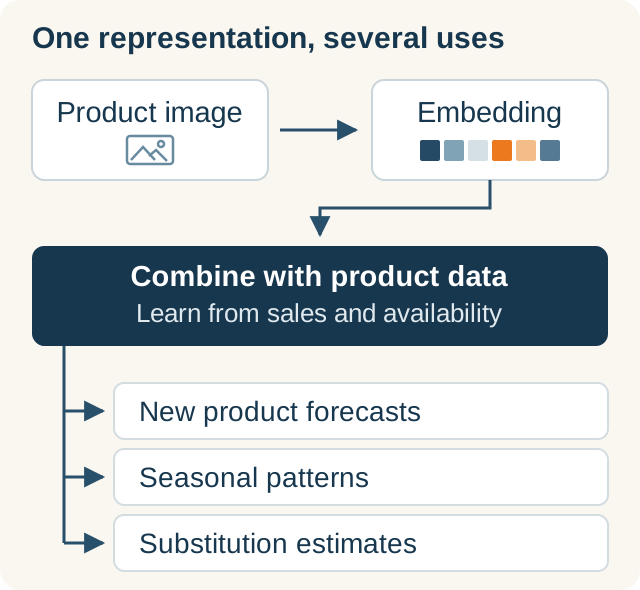
同じ画像表現を複数のモデルに使えます。それぞれの用途に応じた業務上の根拠と検証が必要です。
新商品の発売予測のために開発したレシピに、後から既存の品揃えと競合する新しいスタイルを考慮する必要が生じるかもしれません。その際も視覚情報を引き続き利用できます。サイエンティストは、別の画像処理サービスを構築せずに計算を拡張できます。
数行の背後にあるエンジニアリング
私たちは、別のチームが開発した事前学習済みの画像モデルを利用しています。私たちのエンジニアは、そのモデルを、毎日確実に実行しなければならないサプライチェーンの計算で使えるようにしています。
私の経験では、見た目の類似性を扱うプロトタイプは、Pythonで数時間もあれば作れます。コーディングエージェントが登場する前から取り組みやすい作業でしたが、エージェントによってさらに簡単になりました。しかし、エージェントが生成できるコードの量から、そのコードを引き受けて維持する負担はほとんどわかりません。
ソフトウェアパッケージを組み合わせたプロトタイプは、各パッケージの保守担当者と、その依存先の保守担当者が書いたコードを引き継ぎます。パッケージが侵害されると、そのプロセスがアクセスできるデータや認証情報が危険にさらされます。善意で保守されている有用なパッケージでも、放棄されることがあります。誰かが、どのコードを信頼するかを決め、変更を確認し、全体が動き続けるようにしなければなりません。その周辺サービスのために数千行を生成すれば、さらに保守の責任が増えます。
画像をLokadに保存しておけば、埋め込みを読み取って比較するために必要なのは、わずか数行のEnvisionコードです。サイエンティストは、画像モデルを実行するために画像処理ライブラリをインストールしたり、別のアプリケーションを保守したりする必要がありません。レシピには、視覚情報をサプライチェーンの計算にどう役立てるかを記述します。
Lokadは、画像を読み取り、モデルを動かし、Envisionスクリプトを実行するソフトウェアを保守します。これにより、私たちのエンジニアは画像ファイルから数値計算までの経路を管理できます。依存関係には引き続き判断と保守が必要ですが、その責任は顧客ごとのプロジェクトで繰り返し負うのではなく、プラットフォームチームが担います。
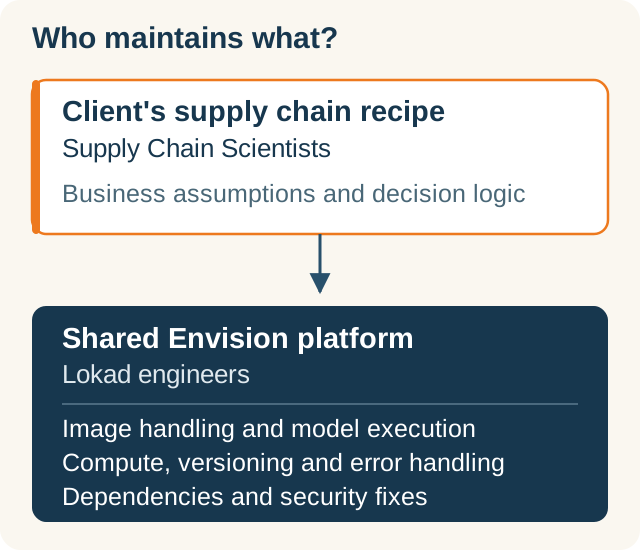
サイエンティストは業務ロジックを保守します。Lokadのプラットフォームチームは、画像処理と計算実行のソフトウェアを保守します。
大規模なカタログの処理では、メモリ使用量に上限が必要です。日々の実行では、変更されていない画像について、すでに行った処理を再利用すべきです。画像が見つからない、あるいは破損している場合、サイエンティストはどの画像が問題を引き起こしたのかを把握する必要があります。処理ソフトウェアの変更は、どの結果を再利用できるかの判断にも反映されなければなりません。私たちは、レシピの残りの部分の実行とともに、これらの課題をプラットフォーム内で扱っています。
こうして、商品の視覚情報を、その説明、価格、販売履歴と同じ計算の中で利用できます。サイエンティストは、これらの信号を生成するソフトウェアを作り直すことなく、その使い方を変更できます。


