
De las fotos de productos a las decisiones de supply chain
Un vestido nuevo llega al catálogo de un minorista con una fotografía, una breve descripción y ningún historial de ventas. Antes de realizar el primer pedido, el comprador necesita comparaciones útiles con productos vendidos anteriormente. El corte y el estampado pueden importar más que una descripción que apenas dice «vestido de mujer».
Lokad ya puede utilizar fotografías de productos en sus cálculos de supply chain. Esta capacidad está integrada en Envision, el lenguaje de programación de Lokad para previsiones y decisiones de supply chain. Convierte cada imagen en un embedding: una descripción numérica compacta que permite utilizar la información visual en esos cálculos.

Qué hace un embedding
Una fotografía contiene millones de valores de píxeles. Un modelo entrenado con imágenes los convierte en una lista de números mucho más corta: el embedding. Estos números representan patrones visuales, como formas, texturas y la disposición de los elementos en la imagen. No son una lista de etiquetas como «azul» o «manga larga».
Comparar dos embeddings proporciona una medida del parecido visual. Dos vestidos de verano con estampado floral suelen parecerse más entre sí que un vestido y un abrigo de invierno, aunque uno de los vestidos tenga una descripción detallada y el otro solo un código de proveedor. El software puede encontrar estas relaciones en todo un catálogo sin que alguien tenga que etiquetar cada característica visible.
Lokad ya utiliza embeddings de texto para comparar descripciones. Los embeddings de imágenes aportan una visión complementaria de productos cuyos nombres y especificaciones escritas pueden contar solo parte de la historia.
Aprender de productos ya vendidos
En un lanzamiento, el parecido visual puede ayudar a seleccionar productos anteriores cuyos historiales de ventas merezcan tener peso. Sus temporadas, canales de venta y disponibilidad siguen siendo relevantes. Un vestido similar puede registrar pocas ventas porque llegó tarde o estuvo agotado con frecuencia. Es necesario interpretar esos registros antes de convertirlos en una previsión para el nuevo artículo.
La estacionalidad ofrece otro uso. Un artículo nuevo no tiene historial estacional, pero productos anteriores con características visuales relacionadas pueden aportar indicios de cuándo se venderá. El patrón estacional procede de ventas fechadas; la imagen ayuda al modelo a decidir qué historiales son pertinentes.
Las imágenes también pueden ayudar a clasificar catálogos con descripciones escasas. Un clasificador entrenado con las categorías propias del minorista puede utilizar información visual para sugerir una categoría o señalar un producto que parece fuera de lugar. Así, el enriquecimiento del catálogo no depende por completo de que alguien etiquete los productos uno a uno.
Para la sustitución y la canibalización, el parecido identifica posibles alternativas. Se necesitan registros de ventas y disponibilidad para estimar si los clientes pasan de una a otra, o si un estilo nuevo desvía la demanda de uno existente. Dos vestidos pueden parecerse y, aun así, dirigirse a clientes distintos con precios diferentes. La imagen aporta indicios a un modelo que debe tener en cuenta esas diferencias.
Una parte reutilizable del cálculo
Una demostración habitual muestra la fotografía de un producto junto a una galería de productos similares. Esto resulta útil para explorar un catálogo. Los cálculos de supply chain necesitan acceder a la representación subyacente para poder utilizarla con otros fines.
En Envision, los embeddings se pueden almacenar y utilizar en cálculos, de forma parecida a los números. Los Supply Chain Scientists de Lokad utilizan este lenguaje para desarrollar la lógica de previsión y decisión de cada cliente. Pueden comparar el embedding de la imagen de un producto con el de otro y combinar señales visuales y textuales en un modelo junto con precios, transacciones y disponibilidad de inventario.
Estos cálculos pueden participar en autodiff, el mecanismo de Envision para aprender los parámetros de un modelo a partir de observaciones. Un científico puede ajustar un modelo que aprenda cómo se relaciona la información visual con las ventas en el negocio del cliente. El modelo de imágenes aporta la representación visual; los registros del cliente enseñan al modelo de supply chain a utilizarla.
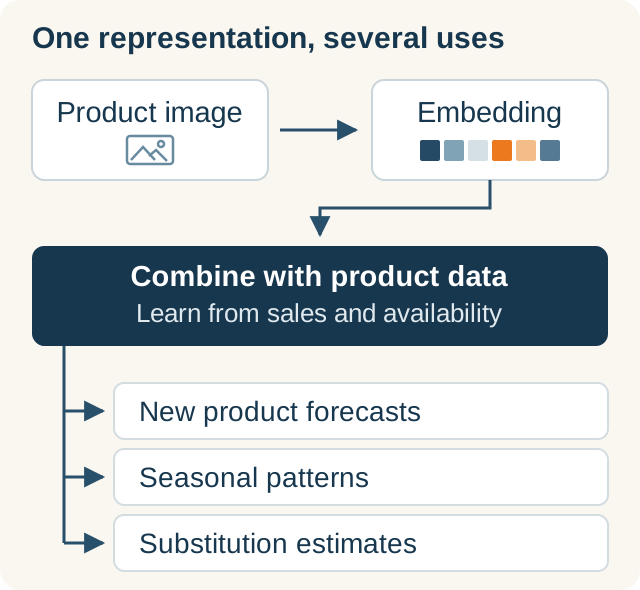
Una misma representación de imagen puede servir a varios modelos. Cada uso necesita sus propios datos del negocio y su propia validación.
Una receta desarrollada para prever lanzamientos podría necesitar más adelante tener en cuenta un estilo nuevo que compite con el surtido existente. La información visual sigue disponible para ese trabajo. El científico puede ampliar el cálculo sin crear otro servicio de procesamiento de imágenes.
La ingeniería detrás de unas pocas líneas
Utilizamos un modelo de imágenes preentrenado desarrollado por otro equipo. Nuestros ingenieros hacen que ese modelo se pueda utilizar en cálculos de supply chain que deben ejecutarse de forma fiable todos los días.
En mi experiencia, crear un prototipo de similitud visual requiere unas pocas horas de trabajo en Python. Ya era asequible antes de los agentes de programación; estos lo facilitan aún más. La cantidad de código que un agente puede producir nos dice poco sobre la carga que supone hacerse responsable de él.
Un prototipo construido a partir de paquetes de software hereda código de sus responsables de mantenimiento y de quienes mantienen sus dependencias. Un paquete comprometido puede poner en riesgo los datos y las credenciales a los que ese proceso tiene acceso. Incluso los paquetes útiles y mantenidos de buena fe pueden abandonarse. Alguien debe decidir en qué código confiar, revisar los cambios y mantener el conjunto en funcionamiento. Generar miles de líneas para el servicio que lo rodea añade otra obligación de mantenimiento.
Con las imágenes almacenadas en Lokad, leer sus embeddings y compararlos requiere unas pocas líneas de Envision. El científico no tiene que instalar una biblioteca de procesamiento de imágenes ni mantener una aplicación separada para ejecutar el modelo de imágenes. La receta especifica cómo contribuye la información visual al cálculo de supply chain.
Lokad mantiene el software que lee las imágenes, ejecuta el modelo y ejecuta los scripts de Envision. Esto da a nuestros ingenieros control sobre el recorrido desde el archivo de imagen hasta el cálculo numérico. Las dependencias siguen exigiendo criterio y mantenimiento, pero esa responsabilidad corresponde al equipo de plataforma en lugar de repetirse en cada proyecto de cliente.
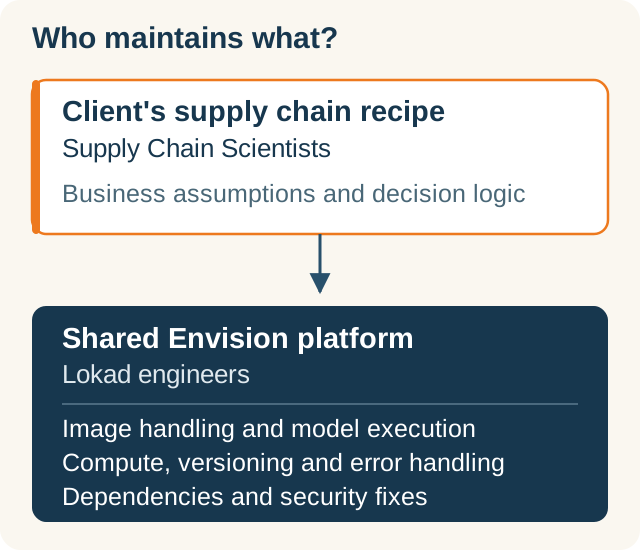
El científico mantiene la lógica del negocio. El equipo de plataforma de Lokad mantiene el software que procesa las imágenes y ejecuta el cálculo.
Procesar un catálogo grande exige limitar el uso de memoria. Las ejecuciones diarias deberían reutilizar el trabajo ya realizado sobre imágenes que no han cambiado. Si falta una imagen o está dañada, el científico necesita saber cuál causó el problema. Los cambios en el software de procesamiento deben reflejarse en qué resultados se pueden reutilizar. Gestionamos estas cuestiones dentro de la plataforma, junto con la ejecución del resto de la receta.
La información visual de un producto puede utilizarse así en los mismos cálculos que su descripción, su precio y su historial de ventas. El científico puede cambiar cómo se utilizan esas señales sin reconstruir el software que las produce.


