
Des photos de produits aux décisions supply chain
Une nouvelle robe entre au catalogue d’un distributeur avec une photo, une courte description et aucun historique de ventes. Avant de passer la première commande, l’acheteur a besoin de comparaisons utiles avec des produits déjà vendus. La coupe et le motif peuvent compter davantage qu’une description qui se limite à « robe pour femme ».
Lokad peut désormais utiliser les photos de produits dans ses calculs supply chain. Cette capacité est intégrée à Envision, le langage de programmation de Lokad pour la prévision et les décisions supply chain. Elle transforme chaque image en un embedding : une représentation numérique compacte qui rend l’information visuelle exploitable dans ces calculs.

À quoi sert un embedding
Une photo contient des millions de valeurs de pixels. Un modèle entraîné sur des images les convertit en une liste de nombres bien plus courte : l’embedding. Ces nombres représentent des motifs visuels, notamment les formes, les textures et la disposition des éléments dans l’image. Ce n’est pas une liste d’étiquettes telles que « bleu » ou « manches longues ».
Comparer deux embeddings donne une mesure de ressemblance visuelle. Deux robes d’été à fleurs seront souvent plus proches l’une de l’autre qu’une robe et un manteau d’hiver, même si l’une dispose d’une description détaillée et l’autre d’un simple code fournisseur. Le logiciel peut repérer ces relations dans tout un catalogue sans qu’une personne ait à étiqueter chaque caractéristique visible.
Lokad utilise déjà des embeddings de texte pour comparer les descriptions. Les embeddings d’images apportent un regard complémentaire sur des produits dont le nom et les caractéristiques écrites ne disent pas tout.
Apprendre des produits déjà vendus
Pour un lancement, la ressemblance visuelle peut aider à sélectionner les produits antérieurs dont l’historique de ventes mérite du poids. Leurs saisons, leurs canaux de vente et leur disponibilité restent essentiels. Une robe similaire peut afficher peu de ventes parce qu’elle est arrivée tard ou qu’elle a souvent été en rupture de stock. Il faut interpréter ces données avant d’en tirer une prévision pour le nouvel article.
La saisonnalité offre un autre usage. Un nouvel article n’a pas d’historique saisonnier, mais des produits plus anciens aux caractéristiques visuelles proches peuvent donner des indications sur les périodes où il se vendra. Le profil saisonnier vient des ventes datées ; l’image aide le modèle à déterminer quels historiques sont pertinents.
Les images peuvent aussi aider à classer des catalogues aux descriptions sommaires. Un classificateur entraîné sur les catégories propres au distributeur peut utiliser l’information visuelle pour suggérer une catégorie ou signaler un produit qui semble mal classé. L’enrichissement du catalogue ne dépend alors plus entièrement d’un étiquetage manuel, produit par produit.
Pour la substitution et la cannibalisation, la ressemblance permet de repérer des alternatives possibles. Les données de ventes et de disponibilité sont nécessaires pour estimer si les clients passent de l’une à l’autre, ou si un nouveau style détourne la demande d’un produit existant. Deux robes peuvent se ressembler tout en s’adressant à des clients différents, à des prix différents. L’image fournit un élément d’appréciation à un modèle qui doit tenir compte de ces différences.
Une composante réutilisable du calcul
Une démonstration classique présente une photo de produit à côté d’une galerie de produits similaires. C’est utile pour parcourir un catalogue. Les calculs supply chain ont besoin d’accéder à la représentation sous-jacente pour pouvoir l’utiliser à d’autres fins.
Dans Envision, les embeddings peuvent être stockés et utilisés dans les calculs, un peu comme des nombres. Les Supply Chain Scientists de Lokad utilisent ce langage pour développer la logique de prévision et de décision de chaque client. Ils peuvent comparer les embeddings d’images de deux produits et combiner les signaux visuels et textuels dans un modèle, aux côtés des prix, des transactions et de la disponibilité des stocks.
Ces calculs peuvent participer à autodiff, le mécanisme d’Envision permettant d’apprendre les paramètres d’un modèle à partir d’observations. Un scientifique peut ajuster un modèle qui apprend le lien entre l’information visuelle et les ventes dans l’activité du client. Le modèle d’image fournit la représentation visuelle ; les données du client apprennent au modèle supply chain à l’utiliser.
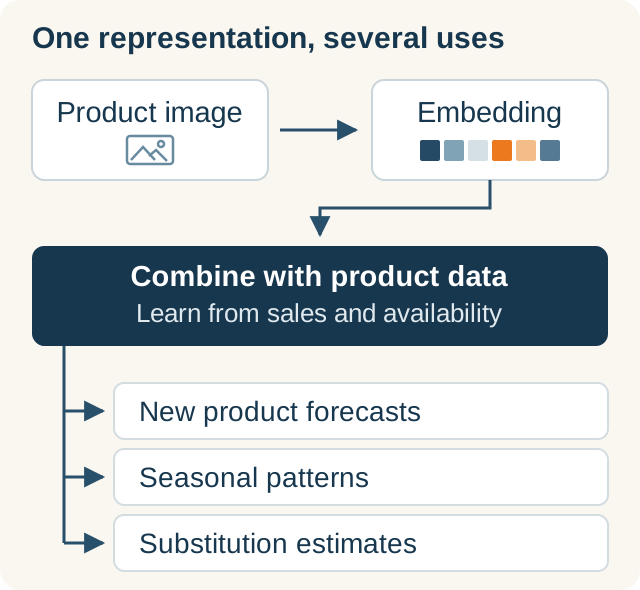
Une même représentation d’image peut servir à plusieurs modèles. Chaque usage exige ses propres données métier et sa propre validation.
Une recette développée pour prévoir les lancements peut ensuite devoir prendre en compte un nouveau style qui concurrence l’assortiment existant. L’information visuelle reste disponible pour ce travail. Le scientifique peut étendre le calcul sans construire un autre service de traitement d’images.
L’ingénierie derrière quelques lignes
Nous utilisons un modèle d’image préentraîné développé par une autre équipe. Nos ingénieurs rendent ce modèle exploitable dans des calculs supply chain qui doivent fonctionner de manière fiable chaque jour.
D’après mon expérience, un prototype de similarité visuelle représente quelques heures de travail en Python. C’était déjà accessible avant les agents de programmation ; ils rendent la tâche encore plus facile. La quantité de code qu’un agent peut produire nous renseigne peu sur la charge que représente sa prise en charge dans la durée.
Un prototype assemblé à partir de paquets logiciels hérite du code de leurs mainteneurs et de celui des mainteneurs de leurs dépendances. Un paquet compromis peut mettre en danger les données et les identifiants auxquels le processus a accès. Même des paquets utiles et maintenus de bonne foi peuvent être abandonnés. Quelqu’un doit décider à quel code faire confiance, examiner les changements et assurer le fonctionnement de l’ensemble. Générer des milliers de lignes pour le service qui l’entoure ajoute une autre obligation de maintenance.
Une fois les images stockées dans Lokad, lire leurs embeddings et les comparer ne demande qu’une poignée de lignes Envision. Le scientifique n’a pas à installer une bibliothèque de traitement d’images ni à maintenir une application distincte pour exécuter le modèle d’image. La recette précise comment l’information visuelle contribue au calcul supply chain.
Lokad maintient le logiciel qui lit les images, exécute le modèle et les scripts Envision. Nos ingénieurs maîtrisent ainsi le chemin qui va du fichier image au calcul numérique. Les dépendances demandent toujours du discernement et de la maintenance, mais cette responsabilité incombe à l’équipe plateforme au lieu d’être répétée dans chaque projet client.
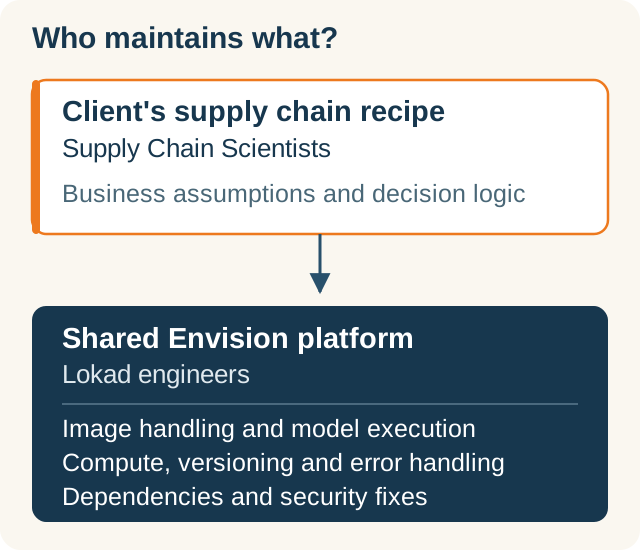
Le scientifique maintient la logique métier. L’équipe plateforme de Lokad maintient le logiciel qui traite les images et exécute le calcul.
Traiter un grand catalogue exige de limiter l’utilisation de la mémoire. Les exécutions quotidiennes doivent réutiliser le travail déjà effectué sur les images inchangées. Si une image manque ou est endommagée, le scientifique doit savoir laquelle a causé le problème. Les changements du logiciel de traitement doivent être pris en compte pour déterminer quels résultats peuvent être réutilisés. Nous gérons ces questions au sein de la plateforme, avec l’exécution du reste de la recette.
L’information visuelle d’un produit peut ainsi être utilisée dans les mêmes calculs que sa description, son prix et son historique de ventes. Le scientifique peut modifier la façon dont ces signaux sont utilisés sans reconstruire le logiciel qui les produit.


